如果数据在原始输入空间里不是线性可分的,我们就需要学习非线性特征。线性假设类具有以下形式:
h θ ( x ) = θ T x , θ ∈ R n × k h_\theta(x) = \theta^T x,\quad \theta \in \mathbb{R}^{n\times k} h θ ( x ) = θ T x , θ ∈ R n × k
对于一个输入 x ∈ R n x \in \mathbb{R}^n x ∈ R n k k k
问题在于假设类(hypothesis class):线性模型在原始特征空间里只能表达线性边界。
一种让线性模型更具表达力的方式是对原始输入做特征映射(相关可参见核技巧 )。如下式:
h θ ( x ) = θ T ϕ ( x ) h_\theta(x) = \theta^T \phi(x) h θ ( x ) = θ T ϕ ( x )
此处,ϕ ( x ) \phi(x) ϕ ( x ) ϕ \phi ϕ ϕ ( x ) \phi(x) ϕ ( x )
ϕ ( x ) = W T x \phi(x) = W^T x ϕ ( x ) = W T x
那么有:
h θ ( x ) = θ T ϕ ( x ) = θ T ( W T x ) = ( θ T W T ) x h_\theta(x) = \theta^T \phi(x) = \theta^T (W^T x) = (\theta^T W^T) x h θ ( x ) = θ T ϕ ( x ) = θ T ( W T x ) = ( θ T W T ) x
可见,把多个线性层堆叠起来,最终还是会合并成一个线性层,所以这个模型依然没法表示非线性的决策边界。为了让模型具备非线性的表达能力,我们应插入一个非线性激活函数:
ϕ ( x ) = σ ( W T x ) \phi(x) = \sigma(W^T x) ϕ ( x ) = σ ( W T x )
那么有
h θ ( x ) = θ T σ ( W T x ) h_\theta(x) = \theta^T \sigma(W^T x) h θ ( x ) = θ T σ ( W T x )
在随机傅里叶特征方法(RFF)中, W W W
在神经网络中:从数据中学习 W W W
1. 神经网络
神经网络可以看作一系列带参数的函数逐层复合而成。人工神经网络(Artificial Neural Networks)是受生物神经网络启发的。但是人类大脑是否使用反向传播的方式进行更新仍是一个开放性问题。
以典型的MLP为例,通过神经网络的输入经历这样几轮过程:隐藏层通常先对输入进行仿射变换 (线性变换+偏置项),再经过非线性激活 ,并将结果传递给下一层;输出层则根据任务决定是否使用额外的激活函数。
x → affine → activation → h 1 → ⋯ → h n → affine → <output activation> → y x \to \text{affine} \to \text{activation} \to h_{1} \to \dots \to h_n \to \text{affine} \to \text{<output activation>} \to y x → affine → activation → h 1 → ⋯ → h n → affine → <output activation> → y
感知机(Perceptron)可以看作早期最简单的人工神经元模型,详情参见感知机 。它先对输入做加权求和与偏置(即仿射变换),再通过阶跃函数作为激活得到输出。感知机的运作方式比较贴近逻辑门,实际上感知机所组成的网络确实可以搭建出各种逻辑计算的网络。但阶跃函数的输出是不连续的,参数发生微小变化时,输出可能保持不变或突然翻转,因此不适合使用梯度下降和反向传播进行训练。后来的神经网络通常使用 Sigmoid、ReLU 等激活函数,使网络更适合基于梯度的方法进行优化。
下面以双层神经网络举例说明。
1.1 例:双层神经网络
一个两层的神经网络可以写成如下形式:
h θ ( x ) = W 2 T σ ( W 1 T x ) h_\theta(x) = W_2^T \sigma(W_1^T x) h θ ( x ) = W 2 T σ ( W 1 T x )
矩阵 W 1 W_1 W 1
矩阵 W 2 W_2 W 2
因此,输入层不参与计算,隐藏层和输出层共两层参与计算。
对于 batch,表示为:
h θ ( X ) = σ ( X W 1 ) W 2 h_\theta(X) = \sigma(X W_1) W_2 h θ ( X ) = σ ( X W 1 ) W 2
1.2 万能逼近定理
带有 ReLU 这类非线性激活函数的神经网络,能够逼近有界区域上很大一类光滑函数。直观地说,ReLU 网络是在构建分段线性近似:只要隐藏单元足够多,这些分段就能把复杂函数拟合得任意好。
万能逼近定理(Universal Function Approximation):在适当的非线性激活函数 下,一个具有足够多隐藏单元的单隐藏层前馈神经网络 ,可以以任意精度逼近闭且有界区域上的任意连续函数。
该定理只保证网络具有这种表示能力,并不保证训练算法能够找到对应参数,也不说明实现该逼近需要多少隐藏单元。
它主要由 Approximation by Superpositions of a Sigmoidal Function 1989 等工作整理得到,其证明了证明了带单隐藏层 、sigmoid 非线性的前馈网络,可以在适当条件下任意精度逼近连续函数。注意到,单隐藏层下的网络就已经具备这一强大的能力,所以即使是极其简单的网络结构也能非常强大。
提示
关于该定理,可以注意两点:
该定理并不意味着一个网络可以用来精确计算任何函数。通常来说,只要有足够多的隐藏层神经元,我们总能找到一个网络,使其输出与目标函数的差异落在我们设定的精度范围内。
该定理表明用神经网络去逼近的函数是连续函数。对于不连续的目标函数,可以尝试用连续函数去近似它。
1.3 L层多层感知机
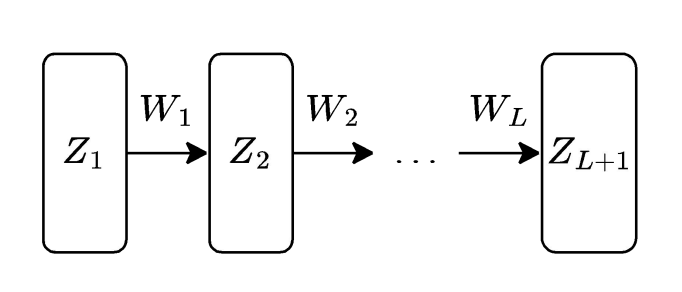
下面给出L层多层感知机(或称前馈网络、全连接网络)的(前向传播)表示:
Z i + 1 = σ i ( Z i W i ) , i = 1 , … , L Z 1 = X , h θ ( X ) = Z L + 1 [ Z i ∈ R m × n i , W i ∈ R n i × n i + 1 ] \begin{aligned} Z_{i+1} &= \sigma_i(Z_i W_i),\; i=1,\dots,L \\ Z_1 &= X, \\ h_\theta(X) &= Z_{L+1} \\ \big[Z_i &\in \mathbb{R}^{m\times n_i},\; W_i \in \mathbb{R}^{n_i\times n_{i+1}}\big] \end{aligned} Z i + 1 Z 1 h θ ( X ) [ Z i = σ i ( Z i W i ) , i = 1 , … , L = X , = Z L + 1 ∈ R m × n i , W i ∈ R n i × n i + 1 ]
其中非线性函数 σ : R → R \sigma: \mathbb{R} \to \mathbb{R} σ : R → R 是逐元素作用的 ,参数如下:
θ = { W 1 , … , W L } \theta = \{ W_1,\dots,W_L \} θ = { W 1 , … , W L }
(上述表示也可以选择加偏置项,即 Z i + 1 = σ i ( Z i W i + b i ) Z_{i+1} = \sigma_i(Z_i W_i + b_i) Z i + 1 = σ i ( Z i W i + b i )
Z i Z_i Z i m m m n i n_i n i i i i W i W_i W i σ i \sigma_i σ i
最终的输出为 Z L + 1 Z_{L+1} Z L + 1
2. 激活函数
2.1 ReLU
ReLU(Rectified linear unit),称为修正线性单元 ,是最受欢迎的激活函数。其形式如下:
R e L U ( x ) = m a x ( 0 , x ) ReLU(x)=max(0,x) R e LU ( x ) = ma x ( 0 , x )
如图,当输入为负时,ReLU函数的导数为0,而当输入为正时,ReLU函数的导数为1。 注意,当输入值精确等于0时,ReLU函数不可导,不过此时我们默认使用左侧的导数,即导数值为 0。下面绘制ReLU函数的导数:
使用ReLU的原因是,它求导表现得特别好:要么让参数消失,要么让参数通过。关于 ReLU,通常需要注意以下几点:
研究发现,跟 sigmoid/tanh 函数比起来,它能让随机梯度下降的收敛速度大大加快。并且它的计算也比其他激活函数更为简单。
ReLU减轻了困扰以往神经网络的梯度消失 问题。例如,采用 sigmoid/tanh 函数,当输入很大或很小时,sigmoid 的导数接近 0,多层连续相乘后,前面层的梯度就可能接近 0。而 ReLU 在正半轴的梯度为 1,在反向传播时就可以显著缓解由激活函数饱和导致的梯度消失。
但ReLU可能引入神经元死亡 的问题。当一个很大的梯度 流过某个 ReLU 神经元时(或者学习率大 ,导致一次剧烈更新后,神经元的预测值总是落在负半轴),可能会导致权重更新到一种状态,使这个神经元以后再也不会对任何数据点激活。如果发生这种情况,那么从这个时刻起,流过这个单元的梯度就会永远是零。
Leaky ReLU :尝试解决"Dying ReLU"问题的一种方法。该变体为ReLU添加了一个线性项,因此即使参数是负的,某些信息仍然可以通过。其形式如下,其中 α \alpha α 较小的固定常数 :
L e a k y R e L U ( x ) = 1 ( x < 0 ) ( a x ) + 1 ( x ≥ 0 ) ( x ) Leaky ReLU(x) = \mathbb{1}(x < 0)(a x) + \mathbb{1}(x \ge 0)(x) L e ak y R e LU ( x ) = 1 ( x < 0 ) ( a x ) + 1 ( x ≥ 0 ) ( x )
Parameterized ReLU,pReLU (参数化ReLU函数 He et al. , 2015 ): 其形式与Leaky ReLU一致,但其中 α \alpha α 可学习参数 :
pReLU ( x ) = max ( 0 , x ) + α min ( 0 , x ) \text{pReLU}(x) = \max(0, x) + \alpha \min(0, x) pReLU ( x ) = max ( 0 , x ) + α min ( 0 , x )
2.2 Sigmoid
对于一个定义域在 R \mathbb{R} R ( 0 , 1 ) (0, 1) ( 0 , 1 ) 挤压函数 (squashing function): 它将范围 ( − i n f , i n f ) (-inf, inf) ( − in f , in f ) ( 0 , 1 ) (0, 1) ( 0 , 1 )
sigmoid ( x ) = 1 1 + exp ( − x ) \text{sigmoid}(x) = \frac{1}{1+\exp(-x)} sigmoid ( x ) = 1 + exp ( − x ) 1
Sigmoid 函数在历史上曾被频繁使用,因为它有一个很好的解释,可以看作神经元的放电率:从完全不放电(0)到以假定的最大频率完全饱和放电(1)。在实践中,Sigmoid 非线性最近已经不再受欢迎,几乎很少使用。它有两个主要缺点:
Sigmoid 会饱和并“杀死梯度”。当神经元的激活在 0 或 1 两端饱和时,这些区域的梯度几乎为零。直接导致我们上一节中提到的梯度消失问题。
Sigmoid 的输出总是正数,不以 0 为中心。如果一个神经元收到的数据总是正的(比如在 f = w T x + b f=w^Tx+b f = w T x + b x > 0 x \gt 0 x > 0 w w w f f f
Sigmoid 函数的导数有如下性质:
d d x sigmoid ( x ) = exp ( − x ) ( 1 + exp ( − x ) ) 2 = sigmoid ( x ) ( 1 − sigmoid ( x ) ) \frac{d}{dx}\text{sigmoid}(x) = \frac{\exp(-x)}{(1+\exp(-x))^2} = \text{sigmoid}(x)\big(1-\text{sigmoid}(x)\big) d x d sigmoid ( x ) = ( 1 + exp ( − x ) ) 2 exp ( − x ) = sigmoid ( x ) ( 1 − sigmoid ( x ) ) 注意,当输入为0时,sigmoid函数的导数达到最大值0.25; 而输入在任一方向上越远离0点时,导数越接近0。
2.3 tanh
tanh(双曲正切)函数的公式如下:
tanh ( x ) = 1 − exp ( − 2 x ) 1 + exp ( − 2 x ) \tanh(x) = \frac{1-\exp(-2x)}{1+\exp(-2x)} tanh ( x ) = 1 + exp ( − 2 x ) 1 − exp ( − 2 x ) 它把一个实数压缩到 ( − 1 , 1 ) (-1, 1) ( − 1 , 1 )
另外还要注意,tanh 神经元其实就是一个缩放过的 sigmoid 神经元,具体来说就是:t a n h ( x ) = 2 s i g m o i d ( 2 x ) − 1 tanh(x)=2sigmoid(2x)−1 t anh ( x ) = 2 s i g m o i d ( 2 x ) − 1
tanh函数的导数是:
d d x tanh ( x ) = 1 − tanh 2 ( x ) \frac{d}{dx}\tanh(x) = 1-\tanh^2(x) d x d tanh ( x ) = 1 − tanh 2 ( x ) 当输入接近0时,tanh函数的导数接近最大值1。 与我们在sigmoid函数图像中看到的类似, 输入在任一方向上越远离0点,导数越接近0。
2.4 maxout
一个神经元内部同时有两(或多)组参数,得到两个仿射结果,然后谁大就输出谁,即:
max ( w 1 T x + b 1 , w 2 T x + b 2 ) \max\left(w_1^T x + b_1,\; w_2^T x + b_2\right) max ( w 1 T x + b 1 , w 2 T x + b 2 ) ReLU 和 Leaky ReLU 都可以看成 Maxout 的特例。因此,Maxout 神经元享有 ReLU 单元的所有好处(运行时处于线性区域,不会饱和),而且没有它的缺点(Dying ReLU)。不过,和 ReLU 神经元不同的是,它会让每一个神经元的参数数量翻倍,从而导致总参数数量很高。
2.5 总结
一般都用 ReLU,其他的基本上排不上用场了(
3. 反向传播(梯度计算)
回想一下,神经网络只是指定了机器学习算法“三要素”中的一个,我们还需要:
• 损失函数:还是交叉熵损失,跟上次一样
为何这里softmax回归和神经网络MLP其损失函数都使用交叉熵损失?多分类假设 ,该假设下最大似然 对应的负对数似然恰好就是交叉熵损失的形式。
换句话说,我们仍然要解决这个优化问题:
min θ 1 m ∑ i = 1 m ℓ c e ( h θ ( x ( i ) ) , y ( i ) ) \min_{\theta} \frac{1}{m}\sum_{i=1}^{m}\ell_{ce}\big(h_{\theta}(x^{(i)}),y^{(i)}\big) θ min m 1 i = 1 ∑ m ℓ ce ( h θ ( x ( i ) ) , y ( i ) )
不过现在的 h θ ( x ) h_\theta(x) h θ ( x ) θ \theta θ
∇ θ ℓ c e ( h θ ( x ( i ) ) , y ( i ) ) \nabla_{\theta}\ell_{ce}\big(h_{\theta}(x^{(i)}),y^{(i)}\big) ∇ θ ℓ ce ( h θ ( x ( i ) ) , y ( i ) )
3.1 双层神经网络
我们来推导一下双层神经网络的梯度,采用batch形式写出来,即求解:
∇ { W 1 , W 2 } ℓ c e ( σ ( X W 1 ) W 2 , y ) \nabla_{\{W_1,W_2\}} \ell_{ce}\big(\sigma(XW_1)W_2,\,y\big) ∇ { W 1 , W 2 } ℓ ce ( σ ( X W 1 ) W 2 , y )
对于 W 2 W_2 W 2 m m m d d d k k k
∂ ℓ c e ( σ ( X W 1 ) W 2 , y ) ∂ W 2 = ∂ ℓ c e ( σ ( X W 1 ) W 2 , y ) ∂ σ ( X W 1 ) W 2 ⋅ ∂ σ ( X W 1 ) W 2 ∂ W 2 = ( S − I y ) m × k ⋅ σ ( X W 1 ) m × d = σ ( X W 1 ) T ⋅ ( S − I y ) [ S = s o f t m a x ( σ ( X W 1 ) W 2 ) ] \begin{aligned} \frac{\partial \ell_{ce}\big(\sigma(XW_1)W_2,\,y\big)}{\partial W_2} &= \frac{\partial \ell_{ce}\big(\sigma(XW_1)W_2,\,y\big)}{\partial \sigma(XW_1)W_2} \cdot \frac{\partial \sigma(XW_1)W_2}{\partial W_2} \\ &= \big(S-I_y\big)_{m\times k} \cdot \sigma(XW_1)_{m\times d} \\ &= \sigma(XW_1)^T \cdot \big(S-I_y\big) \\ \big[S &= \mathrm{softmax}\big(\sigma(XW_1)W_2\big)\big] \end{aligned} ∂ W 2 ∂ ℓ ce ( σ ( X W 1 ) W 2 , y ) [ S = ∂ σ ( X W 1 ) W 2 ∂ ℓ ce ( σ ( X W 1 ) W 2 , y ) ⋅ ∂ W 2 ∂ σ ( X W 1 ) W 2 = ( S − I y ) m × k ⋅ σ ( X W 1 ) m × d = σ ( X W 1 ) T ⋅ ( S − I y ) = softmax ( σ ( X W 1 ) W 2 ) ]
第一步偏导数计算,复用了上一节计算交叉熵损失的导数的结果
第二步偏导数计算,根据链式法则后的简单计算即可
对于 W 1 W_1 W 1
∂ ℓ c e ( σ ( X W 1 ) W 2 , y ) ∂ W 1 = ∂ ℓ c e ( σ ( X W 1 ) W 2 , y ) ∂ ( σ ( X W 1 ) W 2 ) ⋅ ∂ ( σ ( X W 1 ) W 2 ) ∂ σ ( X W 1 ) ⋅ ∂ σ ( X W 1 ) ∂ ( X W 1 ) ⋅ ∂ ( X W 1 ) ∂ W 1 = ( S − I y ) m × k ⋅ ( W 2 T ) k × d ⋅ σ ′ ( X W 1 ) m × d ⋅ X m × n = X T [ ( ( S − I y ) W 2 T ) ⊙ σ ′ ( X W 1 ) ] [ S = s o f t m a x ( σ ( X W 1 ) W 2 ) ] \begin{aligned} \frac{\partial \ell_{ce}\big(\sigma(XW_1)W_2,y\big)}{\partial W_1} &= \frac{\partial \ell_{ce}\big(\sigma(XW_1)W_2,y\big)}{\partial \big(\sigma(XW_1)W_2\big)} \cdot \frac{\partial \big(\sigma(XW_1)W_2\big)}{\partial \sigma(XW_1)} \cdot \frac{\partial \sigma(XW_1)}{\partial (XW_1)} \cdot \frac{\partial (XW_1)}{\partial W_1} \\ &= (S-I_y)_{m\times k}\cdot (W_2^T)_{k\times d}\cdot \sigma'(XW_1)_{m\times d}\cdot X_{m\times n} \\ &= X^T\Big[\big((S-I_y)W_2^T\big)\odot \sigma'(XW_1)\Big] \\ \big[S &= \mathrm{softmax}\big(\sigma(XW_1)W_2\big)\big] \end{aligned} ∂ W 1 ∂ ℓ ce ( σ ( X W 1 ) W 2 , y ) [ S = ∂ ( σ ( X W 1 ) W 2 ) ∂ ℓ ce ( σ ( X W 1 ) W 2 , y ) ⋅ ∂ σ ( X W 1 ) ∂ ( σ ( X W 1 ) W 2 ) ⋅ ∂ ( X W 1 ) ∂ σ ( X W 1 ) ⋅ ∂ W 1 ∂ ( X W 1 ) = ( S − I y ) m × k ⋅ ( W 2 T ) k × d ⋅ σ ′ ( X W 1 ) m × d ⋅ X m × n = X T [ ( ( S − I y ) W 2 T ) ⊙ σ ′ ( X W 1 ) ] = softmax ( σ ( X W 1 ) W 2 ) ]
可以拆解为以下几个中间变量便于理解:
A = X W 1 , H = σ ( A ) , Z = H W 2 , L = ℓ c e ( Z , y ) A = XW_1,\quad H = \sigma(A),\quad Z = HW_2,\quad L = \ell_{ce}(Z,y) A = X W 1 , H = σ ( A ) , Z = H W 2 , L = ℓ ce ( Z , y )
那么我们即需要计算 ∂ L ∂ W 1 \frac{\partial L}{\partial W_1} ∂ W 1 ∂ L L L L 反向传到 W 1 W_1 W 1
从 ce loss 传到 Z Z Z ∂ L ∂ Z = S − I y \frac{\partial L}{\partial Z} = S - I_y ∂ Z ∂ L = S − I y S = s o f t m a x ( Z ) S = softmax(Z) S = so f t ma x ( Z )
从 Z Z Z H H H ∂ L ∂ H = ( S − I y ) W 2 T \frac{\partial L}{\partial H} = (S - I_y)W_2^T ∂ H ∂ L = ( S − I y ) W 2 T
从 H H H A A A 逐元素作用 的,所以其局部导数也逐元素作用在上游梯度上,即 ∂ L ∂ A = ∂ L ∂ H ⊙ σ ′ ( A ) \frac{\partial L}{\partial A} = \frac{\partial L}{\partial H} \odot \sigma^{'}(A) ∂ A ∂ L = ∂ H ∂ L ⊙ σ ′ ( A ) ∂ L ∂ A = ( S − I y ) W 2 T ⊙ σ ′ ( A ) \frac{\partial L}{\partial A} = (S - I_y)W_2^T \odot \sigma^{'}(A) ∂ A ∂ L = ( S − I y ) W 2 T ⊙ σ ′ ( A )
最后从 A A A W 1 W_1 W 1 ∂ L ∂ W 1 = X T ∂ L ∂ A = X T ( ( S − I y ) W 2 T ⊙ σ ′ ( A ) ) \frac{\partial L}{\partial W_1} = X^T \frac{\partial L}{\partial A} = X^T ((S - I_y)W_2^T \odot \sigma^{'}(A)) ∂ W 1 ∂ L = X T ∂ A ∂ L = X T (( S − I y ) W 2 T ⊙ σ ′ ( A ))
关于第 3 步,可以举个例子:如采用 ReLU 激活函数,那么有
σ ′ ( A ) i j = { 1 , A i j > 0 0 , A i j ≤ 0 \sigma'(A)_{ij}= \begin{cases} 1, & A_{ij} \gt 0 \\ 0, & A_{ij} \le 0 \end{cases} σ ′ ( A ) ij = { 1 , 0 , A ij > 0 A ij ≤ 0
在反向传播的时候,上游传来的梯度会跟 ReLU 的导数逐元素相乘。此处神经元通过 ReLU 激活函数,其导数为 1 的位置保留上游梯度,导数为 0 的位置将梯度置零。
3.2 MLP
继续将上述做法推广到我们的 L L L
Z i + 1 = σ i ( Z i W i ) , i = 1 , … , L Z_{i+1} = \sigma_i(Z_i W_i),\quad i=1,\dots,L Z i + 1 = σ i ( Z i W i ) , i = 1 , … , L
注意,Z i + 1 Z_{i+1} Z i + 1 i i i i + 1 i + 1 i + 1 L L L Z L + 1 Z_{L+1} Z L + 1 W i W_i W i
∂ ℓ ( Z L + 1 , y ) ∂ W i = ∂ ℓ ∂ Z L + 1 ⋅ ∂ Z L + 1 ∂ Z L ⋅ ∂ Z L ∂ Z L − 1 ⋅ ⋯ ⋅ ∂ Z i + 2 ∂ Z i + 1 ⏟ G i + 1 ⋅ ∂ Z i + 1 ∂ W i \frac{\partial \ell(Z_{L+1},y)}{\partial W_i} = \underbrace{ \frac{\partial \ell}{\partial Z_{L+1}} \cdot \frac{\partial Z_{L+1}}{\partial Z_L} \cdot \frac{\partial Z_L}{\partial Z_{L-1}} \cdot \cdots \cdot \frac{\partial Z_{i+2}}{\partial Z_{i+1}} }_{G_{i+1}} \cdot \frac{\partial Z_{i+1}}{\partial W_i} \\[1.6em] \kern{7em} ∂ W i ∂ ℓ ( Z L + 1 , y ) = G i + 1 ∂ Z L + 1 ∂ ℓ ⋅ ∂ Z L ∂ Z L + 1 ⋅ ∂ Z L − 1 ∂ Z L ⋅ ⋯ ⋅ ∂ Z i + 1 ∂ Z i + 2 ⋅ ∂ W i ∂ Z i + 1
其中,定义已经从最终 loss 反向传播到第 i + 1 i+1 i + 1 的梯度为:
G i + 1 = ∂ ℓ ( Z L + 1 , y ) ∂ Z i + 1 G_{i+1} = \frac{\partial \ell(Z_{L+1},y)}{\partial Z_{i+1}} G i + 1 = ∂ Z i + 1 ∂ ℓ ( Z L + 1 , y )
那么,对 G i G_i G i
G i = ∂ ℓ ∂ Z i = G i + 1 ⋅ ∂ Z i + 1 ∂ Z i = G i + 1 ⋅ ∂ σ i ( Z i W i ) ∂ Z i W i ⋅ ∂ Z i W i ∂ Z i = G i + 1 ⋅ σ ′ ( Z i W i ) ⋅ W i \begin{aligned} G_{i} &= \frac{\partial \ell}{\partial Z_{i}} \\ &= G_{i+1}\cdot \frac{\partial Z_{i+1}}{\partial Z_{i}} \\ &= G_{i+1}\cdot \frac{\partial \sigma_{i}(Z_{i}W_{i})}{\partial Z_{i}W_{i}}\cdot \frac{\partial Z_{i}W_{i}}{\partial Z_{i}} \\ &= G_{i+1}\cdot \sigma'(Z_{i}W_{i})\cdot W_{i} \end{aligned} G i = ∂ Z i ∂ ℓ = G i + 1 ⋅ ∂ Z i ∂ Z i + 1 = G i + 1 ⋅ ∂ Z i W i ∂ σ i ( Z i W i ) ⋅ ∂ Z i ∂ Z i W i = G i + 1 ⋅ σ ′ ( Z i W i ) ⋅ W i
考虑上述记号中的矩阵维度,那么有
G i = [ G i + 1 ] m × n i + 1 ⋅ σ ′ ( Z i W i ) m × n i + 1 ⋅ [ W i ] n i × n i + 1 = ( G i + 1 ⊙ σ ′ ( Z i W i ) ) W i T \begin{aligned} G_i &= \left[G_{i+1}\right]_{m\times n_{i+1}} \cdot \sigma'(Z_i W_i)_{m\times n_{i+1}} \cdot \left[W_i\right]_{n_i\times n_{i+1}} \\ &= \left(G_{i+1} \odot \sigma'(Z_i W_i)\right) W_i^T \end{aligned} G i = [ G i + 1 ] m × n i + 1 ⋅ σ ′ ( Z i W i ) m × n i + 1 ⋅ [ W i ] n i × n i + 1 = ( G i + 1 ⊙ σ ′ ( Z i W i ) ) W i T
将 G i G_i G i W i W_i W i
∂ ℓ ( Z L + 1 , y ) ∂ W i = G i + 1 ⋅ ∂ Z i + 1 ∂ W i = G i + 1 ⋅ ∂ σ ( Z i W i ) ∂ Z i W i ⋅ ∂ Z i W i ∂ W i = [ G i + 1 ] m × n i + 1 ⋅ σ ′ ( Z i W i ) m × n i + 1 ⋅ [ Z i ] m × n i = Z i T ⋅ [ G i + 1 ⊙ σ ′ ( Z i W i ) ] \begin{aligned} \frac{\partial \ell(Z_{L+1},y)}{\partial W_i} &= G_{i+1}\cdot \frac{\partial Z_{i+1}}{\partial W_i} \\ &= G_{i+1}\cdot \frac{\partial \sigma(Z_i W_i)}{\partial Z_i W_i}\cdot \frac{\partial Z_i W_i}{\partial W_i} \\ &= \left[G_{i+1}\right]_{m\times n_{i+1}} \cdot \sigma'(Z_i W_i)_{m\times n_{i+1}} \cdot \left[Z_i\right]_{m\times n_i} \\ &= Z_i^T \cdot \left[G_{i+1} \odot \sigma'(Z_i W_i)\right] \end{aligned} ∂ W i ∂ ℓ ( Z L + 1 , y ) = G i + 1 ⋅ ∂ W i ∂ Z i + 1 = G i + 1 ⋅ ∂ Z i W i ∂ σ ( Z i W i ) ⋅ ∂ W i ∂ Z i W i = [ G i + 1 ] m × n i + 1 ⋅ σ ′ ( Z i W i ) m × n i + 1 ⋅ [ Z i ] m × n i = Z i T ⋅ [ G i + 1 ⊙ σ ′ ( Z i W i ) ]
3.3 总结
综合以上内容,我们可以按照下面的步骤高效地计算神经网络所需的所有梯度:
前向传播 (forward pass):
初始时:Z 1 = X Z_1 = X Z 1 = X
迭代:Z i + 1 = σ i ( Z i W i ) , i = 1 , … , L Z_{i+1} = \sigma_i(Z_i W_i),\quad i=1,\dots,L Z i + 1 = σ i ( Z i W i ) , i = 1 , … , L
反向传播 (Backward pass):
初始时:G L + 1 = ∇ Z L + 1 ℓ ( Z L + 1 , y ) = S − I y G_{L+1} = \nabla_{Z_{L+1}} \ell(Z_{L+1},y) = S-I_y G L + 1 = ∇ Z L + 1 ℓ ( Z L + 1 , y ) = S − I y
迭代:G i = ( G i + 1 ∘ σ i ′ ( Z i W i ) ) W i T , i = L , … , 1 G_{i} = \left(G_{i+1} \circ \sigma'_{i}(Z_{i}W_{i})\right) W_{i}^{T},\quad i = L,\dots,1 G i = ( G i + 1 ∘ σ i ′ ( Z i W i ) ) W i T , i = L , … , 1
而且我们可以一路算出所有需要的梯度:
∇ W i ℓ ( Z L + 1 , y ) = Z i T ( G i + 1 ∘ σ i ′ ( Z i W i ) ) \nabla_{W_i}\ell(Z_{L+1},y) = Z_i^T\left(G_{i+1}\circ \sigma'_i(Z_i W_i)\right) ∇ W i ℓ ( Z L + 1 , y ) = Z i T ( G i + 1 ∘ σ i ′ ( Z i W i ) )
“反向传播”其实就是链式法则加上对中间结果的缓存。
下节课将把这套机制推广到任意计算图。
参考
https://ickma2311.github.io/ML/DLSys/cmu-dlsys-lecture-3-manual-neural-networks.html Neural Networks and Deep Learning Chapter 1
https://neuralnetworksanddeeplearning.com/chap1.html
DIVE INTO DEEP LEARNING
https://zh.d2l.ai/chapter_multilayer-perceptrons/mlp.html
Neural Networks and Deep Learning Chapter 4
https://neuralnetworksanddeeplearning.com/chap4.html